Your friend. Your new rap partner.
和好友各出一张照片,共用一支麦克风,做一段发进群聊的说唱。
和你最想一起上场的人。
走进橙色录音室,来一段你们的说唱。
上传两张人物照片,生成 Migos AI 风格的双人表演。让 AI 写词,或填入自己的歌词;可选 5、10 或 15 秒,搭配原创伴奏,下载你选择比例的 MP4 视频。
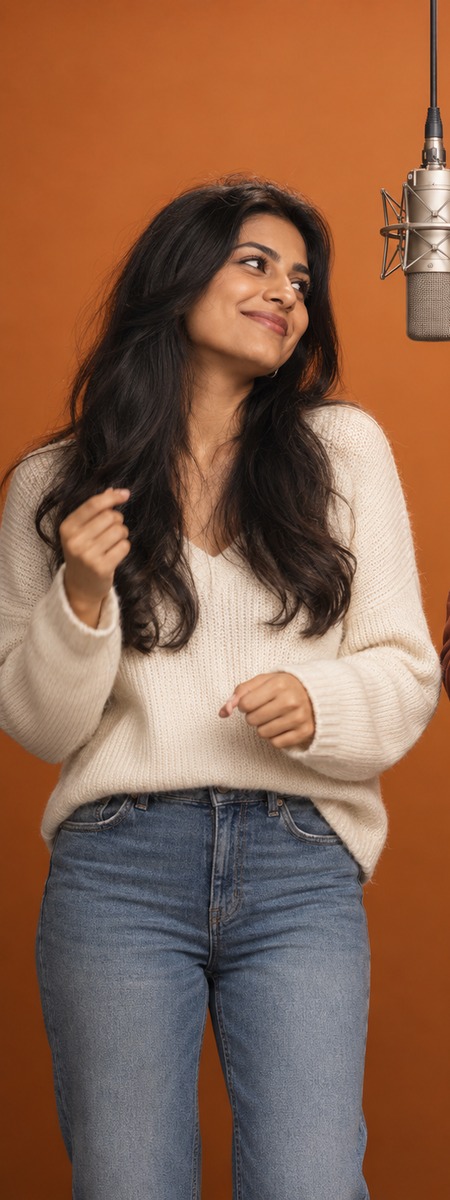 参考照片 ↗
带上两张照片,再选一段想唱的词。舞台、节拍和表演交给我们。
每张照片只包含一位成年人。支持 JPG、PNG、WebP,每张不超过 10 MB。
AI 会用所选语言创作简短的原创歌词。你可以在中文页面生成英文说唱。
人声与口型由 AI 生成,实际歌词、发音和节奏可能出现偏差。
上传人物照片,选好歌词。完成后的说唱视频会在这里出现。
上传两张人物照片,就能生成一段双人说唱视频。你们会在橙色录音室共用一支悬挂麦克风,搭配 AI 人声与原创伴奏。歌词可以让 AI 创作,也可以自己写;视频可选 5、10 或 15 秒,生成后下载 MP4。
这套视觉风格的灵感来自 Quavo 与 Takeoff 在 A COLORS SHOW 上的《Hotel Lobby》表演,也常被称为 Migos AI 或 AI Migos。我们根据你提供的两张照片生成全新的表演。可以邀请朋友、伴侣或成年家人一起创作,请先取得对方同意。
了解 Migos AI 的来历朋友、伴侣、成年家人,都能一起上场。打开声音,看一看这些实际生成的视频,再到示例页对照原始照片与参数,了解效果后再选择规格。
和好友各出一张照片,共用一支麦克风,做一段发进群聊的说唱。
把两张情侣照片变成双人表演,为约会或纪念日准备一点新惊喜。
邀请两位成年家人一起开麦,把生日祝福唱出来,送进家庭群。
以下是真实的 Wan 3.0生成结果,来自 CubistAI 的橙色录音室模板 v5,生成于 2026 年 10 月 7 日。画面中的人物均为虚构成年人。这些历史示例用于展示风格;当前生成器以 v6 为基础扩展,实际效果会有差异。 查看示例详情。
每位人物各一张清楚的成年人照片,并事先获得本人同意。第一张在左,第二张在右,也可以交换位置。
可选 5、10 或 15 秒、480p 或 720p。登录后按需购买点数套餐,开始前确认本次用量;照片、歌词和设置会在当前浏览器保存 24 小时。
提交后,可以到“我的视频”查看进度。完成后打开声音,检查人脸、歌词和表演,再下载 MP4。
所有规格都包含双人表演、AI 音频和 MP4 下载。画面比例可选自动、16:9、4:3、1:1、3:4 或 9:16。480p 消耗的点数更少,720p 画面更清晰;10 秒或 15 秒能容纳更多表演内容。清晰度更高,并不保证人物更像本人。
默认规格为 480p、5 秒,每次使用 80 点数。观看示例、准备照片均免费;生成视频需购买点数,提交前会显示本次用量。
查看全部套餐与价格| 画面清晰度 | 5 秒 | 10 秒 | 15 秒 |
|---|---|---|---|
| 480p标准 | 80点数 | 160点数 | 240点数 |
| 720p高清 | 160点数 | 320点数 | 480点数 |
1.99 美元,包含 160 点数
整包点数用于同一种规格时,可制作 2 支 480p / 5 秒视频,或 1 支 720p / 5 秒视频。剩余点数保留在账户中。
一次购买 · 点数长期有效 · 价格为美元,未含适用税费视觉风格受到 Hotel Lobby 潮流启发,人声、伴奏和动作由 AI 生成。歌词可以自行输入,也可以让 AI 创作。人物相似度、手势、歌词准确度和口型会因生成而异,请先观看示例。本服务不使用原版《Hotel Lobby》录音,也不克隆原艺人的声音,与 Migos 和 COLORS 无关联。
准备两张单人照片,每张只包含一位成年人。面部正对镜头、光线均匀、取景接近,能给模型更清楚的人物参考。如果只有合照,请先将两人分别裁成单独的图片。
第一张照片对应左侧人物,第二张对应右侧人物;可以用交换按钮调整位置。此处预览的是你上传的原图,最终 AI 视频会在生成后显示。
查看选图与问题排查指南支持 JPG、PNG、WebP,每张不超过 10 MB,宽高均至少 240 像素。尽量避开远景人脸和大幅侧脸。
选择无遮挡的脸部。过暗的阴影、墨镜和过度美颜会遮住模型需要参考的细节。
仅使用获得授权的成年人照片。两位人物都需要同意其肖像用于 AI 视频生成。
可以。选择“自己填歌词”,输入希望演唱的原文。每句换一行:先由左侧人物演唱,再由右侧人物演唱,依次交替。模型会被要求保留原文和语言,但实际歌词、发音和口型仍可能出现偏差。
可以。页面支持英文和简体中文,自动写词可选英文或普通话。自定义歌词选择“跟随歌词语言”时,会保留原文的语言,中英混写也可以。切换页面语言不会翻译或替换你的草稿。
上传两张已获授权的成年人照片,安排左右位置,选择画面比例、清晰度和时长。可以让 AI 用英文或普通话写词,也可以自行填入歌词。登录后确认点数用量并提交;成片包含 AI 人声与原创伴奏,可下载 MP4。
这种风格受到 Quavo 与 Takeoff 在 A COLORS SHOW 上的《Hotel Lobby》表演启发:两位人物、橙色背景、一支悬挂麦克风。Migos AI 也是人们对这套视觉形式的称呼。
不会。视频包含新生成的 AI 人声与原创伴奏,不使用原版录音,也不克隆原艺人的声音。人物动作由 AI 生成,并非对原作舞步的逐步复制。
每个账户可免费生成 1 张 AI 录音室照片。视频生成使用购买的点数。首次体验包 1.99 美元,包含 160 点数:可生成 1 支 720p / 5 秒视频,或 2 支 480p / 5 秒视频。仅限首次购买前使用,每个账户限购一次,无需订阅。
480p:5 秒需要 80 点数,10 秒需要 160 点数,15 秒需要 240 点数。720p:5 秒需要 160 点数,10 秒需要 320 点数,15 秒需要 480 点数。首次体验包 1.99 美元起,每个账户限购一次,未含适用税费。点数长期有效,已完成的视频重新生成会再次消耗点数。
完成的视频为含 AI 音频的 MP4。生成前可选自动画面比例、16:9、4:3、1:1、3:4 或 9:16,清晰度为 480p 或 720p,时长为 5、10 或 15 秒。默认竖屏 9:16、480p、5 秒。更高分辨率提升清晰度,不保证人物更像本人。
使用两张清楚、光线均匀的照片,每张只含一位已同意的成年人。正面人脸和接近的取景能提供更好的参考。支持 JPG、PNG、WebP,每张不超过 10 MB,宽高均至少 240 像素。合照请先分别裁成单人照片。
可以。第一张对应左侧人物,第二张对应右侧人物,提交前可用交换按钮调整。模型会被要求保持人物身份独立,但实际相似度与站位仍可能有变化。
通常需要 1–5 分钟,排队时可能更久。这里展示的三支历史示例分别等待了约 97–128 秒。提交后任务会保存在“我的视频”中,离开页面也可以稍后回来查看。
确认属于技术性失败后,预留点数会退回一次。待处理任务会保留点数,直到状态明确。已完成的视频重新生成会再次使用点数。
两张照片会引导人物表演,但相似度、手部、口型和歌词都可能有偏差。购买前请观看真实示例。提高分辨率能让画面更清晰,不保证更像本人。
照片、歌词和设置会在当前浏览器保存为草稿,24 小时后过期。原始照片计划在 24 小时后删除,通常在 48 小时内完成;未结束的任务所需照片会保留到状态明确。视频可访问 30 天,通常在 31 天内删除。你可在“我的视频”中主动删除作品及自定义歌词,详情见隐私政策。
从选照片、填歌词到设置规格、购买点数和下载成片,一步步完成你的第一支作品。
人脸不清楚、人物混在一起、上传失败或任务迟迟未完成?这里有对应的检查方法。
了解这一视觉潮流的出处,以及本生成器如何创作新的声音和动作。